11. Juni 2026
Künstliche Intelligenz in der Fertigung: Warum Ihre Smart Factory an den Stammdaten scheitert – und wie Sie das ändern
Von Philipp Seibald
Vice President Sales
21 min Lesezeit
Diesen Beitrag teilen
Künstliche Intelligenz in der Fertigung soll Maschinenausfälle vorhersagen, Pläne in Echtzeit anpassen und Fehler finden, bevor ein Teil das Werk verlässt. In vielen Werken bleibt es beim Pilotprojekt. Der Grund liegt selten im Algorithmus. Er liegt in Materialnummern, Stücklisten und Anlagendaten, die in jedem System etwas anderes bedeuten. Dieser Leitfaden zeigt, welche Daten die wichtigsten KI-Use-Cases wirklich brauchen – und wie Sie aus dem Pilot einen skalierbaren Betrieb machen.
Das Wichtigste in Kürze
KI ist in der Industrie angekommen, aber nicht skaliert: 40 % der deutschen Industrieunternehmen setzen KI in der Produktion ein, 46 % sehen sich trotzdem als Nachzügler.
Der Engpass sind Daten: 44 % der Unternehmen, die KI erwogen, aber nicht eingeführt haben, nennen Probleme mit Verfügbarkeit oder Qualität der Daten.
Ohne KI-fähige Daten kein Betrieb: Gartner erwartet, dass bis Ende 2026 60 % der KI-Projekte ohne KI-fähige Daten abgebrochen werden.
Die drei stärksten Use Cases – KI in der Instandhaltung, in der Produktionsplanung und in der Qualitätssicherung – hängen an denselben Stammdaten: Material, Stückliste, Equipment, Arbeitsplan und Lieferant.
Das Kernproblem ist Identität: Eine KI muss wissen, was ein Objekt ist, bevor sie lernen kann, wie es sich verhält. Das leistet ein Golden Record pro Material und Anlage.
Der Weg zur Skalierung beginnt beim Use Case, nicht bei der Plattform: Wer die Datenbasis für einen Anwendungsfall sauber aufbaut, kann sie für den nächsten wiederverwenden.
Regulierung wird konkret: Der EU Data Act gilt seit 12. September 2025, die KI-Pflichten für Maschinen nach dem EU AI Act greifen ab 2. August 2028.
Was ist künstliche Intelligenz in der Fertigung?
Künstliche Intelligenz in der Fertigung bezeichnet den Einsatz lernender Algorithmen, die Daten aus Produktion, Logistik und Engineering auswerten, um Entscheidungen vorzubereiten oder automatisiert zu treffen. Dazu zählen Machine Learning, Computer Vision, Zeitreihenanalyse, Optimierungsverfahren und zunehmend generative KI sowie KI-Agenten.
Typische Ziele sind höhere Anlagenverfügbarkeit, stabilere Qualität, kürzere Durchlaufzeiten und ein geringerer Energie- und Materialeinsatz. Die Datenquellen reichen von Sensoren und Steuerungen über das Manufacturing Execution System (MES) bis zu ERP-Systemen wie SAP S/4HANA und PLM-Lösungen.
Entscheidend für das Verständnis: Eine KI in der Fertigung verarbeitet zwei Arten von Daten. Bewegungsdaten beschreiben, was passiert – Temperaturverläufe, Taktzeiten, Prüfergebnisse, Aufträge. Stammdaten beschreiben, worauf sich diese Ereignisse beziehen – welches Material, welche Maschine, welcher Arbeitsplan, welcher Lieferant. Ohne verlässliche Stammdaten fehlt den Bewegungsdaten der Kontext.
Abgrenzung: KI, Smart Factory und Industrie 4.0
Die Begriffe werden oft synonym verwendet. Sie beschreiben aber unterschiedliche Ebenen:
Industrie 4.0 ist das Leitbild der vernetzten, digital gesteuerten Produktion – mit IoT-Plattformen, digitalen Zwillingen und durchgängigem Datenaustausch.
Smart Factory ist die konkrete Umsetzung dieses Leitbilds in einem Werk: Maschinen, Systeme und Menschen tauschen Informationen in Echtzeit aus und steuern Abläufe weitgehend selbst.
Künstliche Intelligenz in der Fertigung ist die Analyse- und Entscheidungsschicht dieser Smart Factory. Sie macht aus vernetzten Daten Vorhersagen, Empfehlungen und Aktionen.
Kurz gesagt: Industrie 4.0 vernetzt, die Smart Factory organisiert, die KI entscheidet. Und alle drei Ebenen setzen voraus, dass jedes Objekt in der Fabrik eindeutig identifiziert ist. Was das für Stammdaten grundsätzlich bedeutet, beschreiben wir im Beitrag MDM & AI-Readiness: Warum Daten über KI-Erfolg entscheiden.
Wie verbreitet ist KI in der Fertigung? Die Zahlen für 2026
Die Frage ist längst nicht mehr, ob KI in der Fertigung ankommt. Die Frage ist, warum so wenige Unternehmen den Schritt vom Pilot in den Regelbetrieb schaffen. Die aktuelle Studienlage zeichnet ein klares Bild.
Kennzahl | Wert | Quelle |
Industrieunternehmen in Deutschland mit KI in der Produktion | 40 % (weitere 38 % planen) | |
Industrieunternehmen, die sich bei KI als Nachzügler sehen | 46 % | |
Industrieunternehmen, die KI-Potenziale bereits gut nutzen | 24 % | |
Unternehmen mit 250+ Beschäftigten, die KI nutzen (alle Branchen) | 57 % | |
KI-Initiativen, die den erwarteten ROI geliefert haben | 25 % | |
KI-Initiativen, die unternehmensweit skaliert wurden | 16 % | |
Unternehmen ohne (sichere) KI-taugliche Datenmanagement-Praktiken | 63 % |
Drei Befunde stechen heraus.
Erstens: Die Nutzung wächst, die Wirkung nicht im selben Tempo.
Laut McKinsey State of AI 2026 nutzen fast neun von zehn befragten Organisationen KI regelmäßig in mindestens einer Funktion. Nur 6 % gelten jedoch als „AI High Performer“, die mindestens 5 % ihres EBIT auf KI zurückführen.
Zweitens: Wer skaliert, verdient.
Die Deloitte 2025 Smart Manufacturing Survey unter 600 Führungskräften großer Industrieunternehmen berichtet von rund 20 % mehr Produktionsoutput, 20 % höherer Mitarbeiterproduktivität und 15 % zusätzlich freigesetzter Kapazität durch Smart-Manufacturing-Initiativen. Auf Werks- oder Netzwerkebene setzen allerdings erst 29 % KI und Machine Learning ein.
Drittens: Die Hürde ist die Datenbasis.
In der IBM-Studie räumt die Hälfte der 2.000 befragten CEOs ein, dass schnelle Investitionen zu einer fragmentierten Technologielandschaft geführt haben. 68 % halten eine integrierte, unternehmensweite Datenarchitektur für entscheidend. Die deutschen Zahlen bestätigen das: Für 44 % der Unternehmen, die KI erwogen, aber nicht eingeführt haben, sind Verfügbarkeit oder Qualität der Daten ein Hindernis.
Was Spitzenwerke anders machen, zeigt das Global Lighthouse Network des World Economic Forum. 94 % der dort ausgezeichneten Transformationen kombinieren mehrere Technologiefelder – KI wird meist zusammen mit IoT, Cloud und digitalen Zwillingen eingesetzt. Das funktioniert nur, wenn alle diese Systeme dieselben Objekte meinen.
KI in der Fertigung: Die wichtigsten Use Cases und ihre Datenbasis
Nicht jeder KI-Anwendungsfall stellt dieselben Anforderungen. Wer verstehen will, warum ein Pilot stockt, muss für jeden Use Case fragen: Auf welche Stammdaten stützt sich das Modell – und wie verlässlich sind sie?
KI in der Instandhaltung: Predictive Maintenance
KI in der Instandhaltung ist der am weitesten verbreitete Einstieg. Laut Bitkom setzten bereits Anfang 2025 32 % der Industrieunternehmen KI zur Zustandsüberwachung von Maschinen ein, weitere 42 % planten oder diskutierten es.
Das Prinzip: Modelle erkennen in Vibrations-, Temperatur- oder Stromdaten Muster, die einem Ausfall vorausgehen. Die Instandhaltung kann dann planen, statt zu reagieren.
Damit das gelingt, braucht das Modell mehr als Sensordaten. Es muss wissen, zu welcher Anlage ein Sensor gehört, wo diese Anlage in der Equipment-Hierarchie sitzt, welcher Baureihe sie angehört und welche Ersatzteile verbaut sind. Fehlt diese Zuordnung, lernt die KI aus Zeitreihen, die sie keiner Maschine sicher zuordnen kann. Das Ergebnis sind Fehlalarme – und ein Instandhaltungsteam, das dem System nach wenigen Wochen nicht mehr glaubt.
KI in der Produktionsplanung
KI in der Produktionsplanung optimiert Reihenfolgen, Rüstzeiten und Kapazitäten. Sie reagiert auf Eilaufträge, Materialengpässe oder Maschinenstörungen und schlägt neue Pläne vor. KI-Agenten gehen einen Schritt weiter: Sie lösen Umplanungen selbst aus.
Die Datenbasis dafür sind Stücklisten, Arbeitspläne, Arbeitsplätze, Materialstammdaten mit Wiederbeschaffungszeiten und Lieferantenstammdaten. Jede Unstimmigkeit wirkt hier direkt. Eine veraltete Stücklistenposition führt zu einem Plan, der ein nicht mehr verbautes Teil reserviert. Eine falsche Wiederbeschaffungszeit führt zu einem Plan, der auf Material wartet, das nicht kommt.
Laut McKinsey State of AI 2026 priorisieren Unternehmen der fortgeschrittenen Fertigung KI-Agenten vor allem in Supply Chain, Bestandsmanagement und Prozessoptimierung. Gerade dort entscheidet die Qualität der Stamm- und Strukturdaten über den Nutzen. Warum die Stückliste dabei im Zentrum steht, erklären wir in Warum die Stammdaten Ihrer Stückliste das Herz Ihrer Produkte sind.
KI in der Qualitätssicherung
KI in der Qualitätssicherung nutzt vor allem Computer Vision: Kameras prüfen Oberflächen, Schweißnähte oder Bestückungen und erkennen Abweichungen schneller und konsistenter als eine Sichtprüfung. Dazu kommen Modelle, die Prozessparameter mit Prüfergebnissen verknüpfen und Ursachen für Ausschuss finden.
Auch hier entscheidet der Kontext. Die KI muss wissen, welche Materialvariante gerade geprüft wird, welche Toleranzen gelten, welcher Lieferant die Charge geliefert hat und auf welcher Linie das Teil gefertigt wurde. Sind Varianten in ERP und MES unterschiedlich angelegt, vergleicht das Modell Äpfel mit Birnen. Es meldet Fehler, wo keine sind, und übersieht echte.
Fertigungsoptimierung und Energiemanagement
Fertigungsoptimierung umfasst Prozessparameter, Durchlaufzeiten, Ausschussquoten und Energieverbrauch. Im Energiemanagement sehen Industrieunternehmen besonders großes Potenzial: 85 % nennen es als Anwendungsfeld mit den größten KI-Chancen.
Um Energie einem Produkt, einem Auftrag oder einer Anlage zuzuordnen, braucht die KI wieder dieselbe Grundlage: eindeutige Anlagen, eindeutige Materialien, eindeutige Kostenstellen und Standorte. Das gilt umso mehr, wenn die Ergebnisse in die Nachhaltigkeitsberichterstattung einfließen.
Generative KI und KI-Agenten in der Fabrik
Neben klassischem Machine Learning zieht generative KI in die Werke ein. Instandhaltungs-Assistenten beantworten Fragen zu Fehlercodes, Arbeitsvorbereiter lassen sich Prüfanweisungen entwerfen, Einkäufer fragen Lieferantenbewertungen in natürlicher Sprache ab. KI-Agenten gehen weiter und lösen Aktionen selbst aus – eine Bestellung, eine Umplanung, einen Wartungsauftrag.
Für diese Systeme gilt dieselbe Regel in verschärfter Form. Ein Sprachmodell formuliert auch dann überzeugend, wenn es die falsche Quelle nutzt. Fragt ein Techniker nach dem Wartungsintervall einer Pumpe, muss der Assistent wissen, welche Pumpe, welche Baureihe und welcher Revisionsstand gemeint sind. Ist das Handbuch mit der falschen Anlage verknüpft, ist die Antwort präzise formuliert und trotzdem falsch.
Agenten verstärken diesen Effekt, weil sie nicht nur antworten, sondern handeln. Eine Umplanung auf Basis einer veralteten Stückliste ist kein Anzeigefehler mehr, sondern ein realer Eingriff in die Produktion. Je mehr Autonomie ein System erhält, desto verbindlicher müssen die Stammdaten sein, auf die es sich stützt.
Use Cases und Datenbedarf im Überblick
Die folgende Tabelle fasst zusammen, welche Stammdaten jeder Use Case benötigt, welche Datenfehler typisch sind und was sie im KI-Modell auslösen.
Use Case | Kritische Stammdaten | Typischer Datenfehler | Folge im KI-Modell | Stammdaten-Hebel |
KI in der Instandhaltung | Equipment, Equipment-Hierarchie, Baureihe, Ersatzteile, Standort | Sensor ist keiner Anlage eindeutig zugeordnet; gleiche Anlage in MES und Instandhaltungssystem unterschiedlich benannt | Fehlalarme, nicht übertragbare Modelle zwischen Linien | Golden Record pro Anlage mit verbindlicher Hierarchie |
KI in der Produktionsplanung | Material, Stückliste, Arbeitsplan, Arbeitsplatz, Lieferant, Wiederbeschaffungszeit | Veraltete Stücklistenpositionen; abweichende Mengeneinheiten zwischen ERP und MES | Unrealistische Pläne, Fehlreservierungen, Planer übersteuern das System | Synchronisierte Material- und Stücklistendaten über PLM, ERP und MES |
KI in der Qualitätssicherung | Materialvariante, Prüfmerkmale, Toleranzen, Lieferant, Linie | Varianten mehrfach angelegt; Toleranzen nur lokal gepflegt | Falsch-positive und falsch-negative Prüfentscheidungen | Eindeutige Variantenlogik und zentral gepflegte Prüfmerkmale |
Fertigungsoptimierung und Energie | Anlage, Kostenstelle, Standort, Material, Auftrag | Energiezähler nicht eindeutig Anlagen oder Kostenstellen zugeordnet | Verbrauch nicht verursachungsgerecht zuordenbar | Konsistente Organisations- und Anlagenstruktur |
Generative KI und KI-Agenten (z. B. Instandhaltungs-Assistent) | Alle oben genannten plus Dokumente und Handbücher je Anlage | Dokumente nicht mit dem richtigen Equipment verknüpft | Antworten zur falschen Maschine oder Revision | Golden Record als Referenz für Dokumentenverknüpfung |
Das Muster ist eindeutig: Unabhängig vom Use Case stützt sich jedes Modell auf eine Handvoll Objekte. Wer diese Objekte einmal sauber führt, legt das Fundament für alle weiteren Anwendungsfälle.
Warum KI-Projekte in der Fertigung im Pilot stecken bleiben
In Gesprächen mit Werksleitern, IT-Verantwortlichen und Instandhaltungsleitern hören wir selten, dass das Modell schlecht war. Wir hören: „Der Pilot lief gut. Beim zweiten Werk hat es nicht mehr funktioniert.“ Hinter diesem Satz stehen fast immer dieselben Ursachen.
Ein Bauteil, viele Identitäten
Das klassische Beispiel: Das Lager führt ein Teil als „Schraube A“, die Buchhaltung als „Teil 123“, die Produktion als „Fixierung Silber“. Für Menschen ist das lästig. Für eine KI ist es ein Rätsel.
In Unternehmen mit mehreren Werken vervielfacht sich das Problem. Jedes Werk hat seine eigenen Materialnummern, eigene Kurztexte und eigene Klassifizierungen angelegt. Nach Übernahmen kommen weitere ERP-Mandanten hinzu.
Ein Modell, das in Werk A gelernt hat, erkennt in Werk B dieselben Teile nicht wieder. Dubletten in den Materialstammdaten sind deshalb nicht nur ein Kostenthema für Einkauf und Lager. Sie sind die häufigste Ursache dafür, dass KI-Modelle nicht übertragbar sind.
Sensordaten ohne Kontext
Viele Smart-Factory-Initiativen starten mit einer IoT-Plattform. Sensoren liefern Millionen Datenpunkte, ein Data Lake speichert sie. Was fehlt, ist die Verbindung zur betriebswirtschaftlichen Realität.
Ein Sensor-Tag wie „L3_M07_TEMP_02“ sagt dem Modell nichts darüber, welcher Anlagentyp das ist, wann die letzte Wartung war oder welches Produkt gerade läuft. Diese Informationen liegen im Instandhaltungs- und im ERP-System – oft unter einer anderen Bezeichnung. Bitkom zeigt, dass digitale Zwillinge und IoT-Plattformen bereits bei 45 % der Industrieunternehmen im Einsatz sind. Ohne verbindliche Anlagenstammdaten bleibt der digitale Zwilling jedoch ein Abbild ohne Identität.
Stücklisten-Brüche zwischen PLM, ERP und MES
Die Konstruktion arbeitet mit der Engineering-Stückliste im PLM-System. Die Fertigung arbeitet mit der Fertigungsstückliste im ERP und im MES. Zwischen beiden liegen Änderungsstände, Varianten und lokale Anpassungen.
Für die Produktionsplanung mit KI ist das kritisch. Ein Modell, das Materialbedarfe vorhersagt, muss wissen, welcher Stand gerade gültig ist. Liegen PLM, ERP und MES auseinander, optimiert die KI auf eine Struktur, die es so in der Halle nicht gibt.
Niemand ist für die Daten verantwortlich
Die vierte Ursache ist organisatorisch. Stammdaten werden in vielen Unternehmen von denen gepflegt, die sie gerade brauchen – im Werk, im Einkauf, in der Konstruktion. Verbindliche Regeln, wer welches Feld pflegt und freigibt, fehlen.
Das ist kein Vorwurf an die Teams. Es ist ein Strukturproblem. Laut Bitkom fehlt 42 % der Industrieunternehmen die Expertise, KI in bestehende Prozesse zu integrieren. Ein großer Teil dieser Integration ist Daten-Governance: klare Data Owner, definierte Freigabe-Workflows und messbare Qualitätsregeln.
Kein Algorithmus-Problem, sondern ein Identitätsproblem
An diesem Punkt lohnt sich ein Perspektivwechsel. Die meisten Diskussionen über KI in der Fertigung drehen sich um Modelle, Plattformen und Rechenleistung. Die entscheidende Frage ist eine andere: Weiß Ihre KI, worüber sie spricht?
Ein Machine-Learning-Modell lernt Zusammenhänge zwischen Merkmalen und Ergebnissen. Damit es das kann, muss jede Beobachtung einem Objekt eindeutig zugeordnet sein: dieser Sensor zu dieser Pumpe, dieser Prüfwert zu dieser Variante, dieser Auftrag zu dieser Stückliste. Fehlt diese Zuordnung, lernt das Modell Rauschen. Das ist kein Mangel an Datenmenge – es ist ein Mangel an Identität.
Das ändert die Projektlogik grundlegend:
Statt mehr Daten zu sammeln, klären Sie, welche Objekte ein Use Case kennen muss.
Statt jedes KI-Projekt seine Daten selbst bereinigen zu lassen, schaffen Sie eine gemeinsame Referenz.
Statt das Problem an die Data Scientists zu delegieren, machen Sie Stammdaten zur Aufgabe von Werk, Einkauf und Konstruktion.
Diese gemeinsame Referenz ist der Golden Record: ein verbindlicher, konsolidierter Datensatz pro Material, Anlage oder Lieferant, auf den sich alle Systeme beziehen. Er ersetzt weder ERP noch MES. Er sorgt dafür, dass beide dasselbe meinen. Wie ein Golden Record aufgebaut und dauerhaft gepflegt wird, beschreibt unser Beitrag Golden Record Stammdaten: Aufbau, Pflege & Governance.
Für die Geschäftsführung übersetzt sich dieser Perspektivwechsel in eine einfache Rechnung. Gartner beziffert die durchschnittlichen Kosten schlechter Datenqualität auf 12,9 Millionen US-Dollar pro Unternehmen und Jahr. In der Fertigung kommt ein zweiter Effekt hinzu: Jeder KI-Use-Case, der auf ungeklärten Stammdaten aufsetzt, bezahlt die Datenbereinigung erneut.
Lösungsansatz: In sechs Schritten vom Pilot zur skalierbaren KI in der Fertigung
Der folgende Ansatz setzt beim Anwendungsfall an, nicht bei der Plattform. Er folgt der Logik, die auch Gartner für KI-fähige Daten empfiehlt: Daten an konkreten Use Cases ausrichten, Governance festlegen, Datenqualität laufend absichern.
Schritt 1: Einen Use Case mit belastbarem Business Case wählen
Starten Sie mit einem Anwendungsfall, dessen Nutzen sich in Euro ausdrücken lässt: ungeplante Stillstandsstunden, Ausschusskosten, Bestandswert, Rüstzeiten. KI in der Instandhaltung ist oft ein guter Einstieg, weil Stillstandskosten in den meisten Werken bekannt sind.
Wichtig ist die Auswahl eines Use Cases, der auf mehrere Werke oder Linien übertragbar ist. Nur dann zahlt sich die Arbeit an den Stammdaten mehrfach aus.
Schritt 2: Die Datenlandkarte für diesen Use Case erstellen
Halten Sie fest, welche Objekte das Modell kennen muss – zum Beispiel Anlage, Baureihe, Ersatzteil, Standort.
Dann prüfen Sie für jedes Objekt: In welchen Systemen ist es angelegt? Unter welcher Nummer? Wer pflegt es? Wie vollständig ist es?
Diese Landkarte macht sichtbar, wo die eigentlichen Brüche liegen. Häufig zeigt sich, dass nicht die Sensordaten fehlen, sondern die Zuordnung zwischen IoT-Plattform, Instandhaltungssystem und ERP.
Schritt 3: Golden Records für die kritischen Objekte aufbauen
Konsolidieren Sie die Objekte aus der Datenlandkarte zu Golden Records. Das bedeutet: Dubletten erkennen und zusammenführen, Pflichtattribute definieren, Klassifizierungen vereinheitlichen und festlegen, welches System für welches Attribut führend ist.
Beginnen Sie mit den Objekten, die der Use Case wirklich braucht. Ein vollständiges Materialstamm-Projekt über alle Werke ist ein Mehrjahresvorhaben. Ein sauberer Anlagenstamm für eine Linie ist in Wochen machbar – und sofort nutzbar.
Schritt 4: Governance im Werk verankern
Legen Sie für jedes Objekt einen Data Owner fest, der fachlich verantwortlich ist. Definieren Sie Freigabe-Workflows für neue Materialien, Anlagen und Änderungen. Hinterlegen Sie Qualitätsregeln, die automatisch geprüft werden.
Governance funktioniert in der Fertigung nur, wenn sie nah am Werk ist. Ein zentrales Datenteam setzt die Regeln, die Pflege passiert dort, wo das Wissen liegt. Wie solche Workflows konkret aussehen, beschreibt unser Beitrag zu den vier Datendimensionen für dauerhaft hohe Stammdatenqualität.
Schritt 5: Den Stammdaten-Kontext in die KI-Pipeline integrieren
Jetzt verbinden Sie die Golden Records mit den Systemen, aus denen das Modell lernt und in die es zurückschreibt: IoT-Plattform, MES, Data Lake, ERP. Über Schnittstellen erhält jede Zeitreihe und jedes Prüfergebnis den verbindlichen Objektbezug.
Für generative KI und KI-Agenten bietet sich ein zusätzlicher Weg an. Über das Model Context Protocol (MCP) können KI-Assistenten direkt und kontrolliert auf geprüfte Stammdaten zugreifen, statt auf Kopien in Dokumenten. Wie Goldright das umsetzt, zeigt die native MCP-Integration für Enterprise-KI.
Schritt 6: Messen, nachweisen, skalieren
Messen Sie zwei Dinge parallel: die Wirkung des Use Cases (etwa vermiedene Stillstände) und die Qualität der zugrunde liegenden Stammdaten (etwa Vollständigkeit, Dublettenquote, Aktualität). Beide Werte gehören in dasselbe Reporting.
Wenn der erste Use Case stabil läuft, übertragen Sie ihn auf das nächste Werk. Der Aufwand sinkt deutlich, weil die Objekte bereits sauber geführt sind. Mit jedem weiteren Use Case wächst die gemeinsame Datenbasis – und mit ihr der Return on Investment.
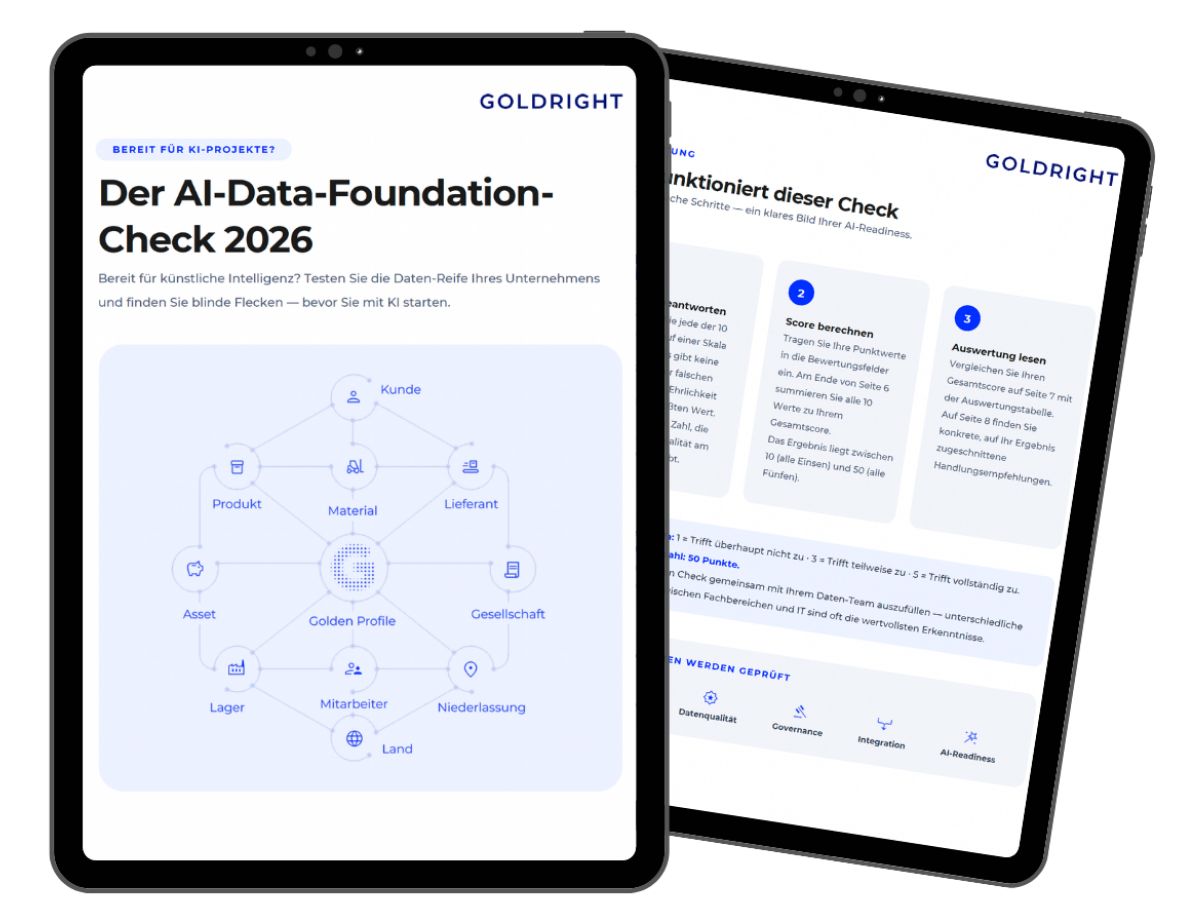
Wie KI-fähig sind die Stammdaten in Ihrem Werk?
Der AI Data Foundation Check zeigt Ihnen in kurzer Zeit, wo Ihre Material-, Stücklisten- und Anlagendaten heute stehen – und welche Lücken Ihre KI-Use-Cases in Instandhaltung, Planung und Qualitätssicherung ausbremsen. Mit klarer Priorisierung für den ersten skalierbaren Anwendungsfall.
Was das für Ihre Rolle bedeutet
KI in der Fertigung ist kein reines IT-Projekt. Sie verändert, wie Geschäftsführung, Werk und IT zusammenarbeiten. Die Perspektiven unterscheiden sich, das Fundament ist dasselbe.
Für die Geschäftsführung geht es um den Return on Investment. Investitionen in Smart-Factory-Technologie sollen messbar wirken – in Anlagenverfügbarkeit, Liefertreue und Kosten pro Stück. Die zentrale Frage lautet: Skaliert das, was im Pilot funktioniert hat, auf alle Werke? Eine verbindliche Stammdatenbasis ist die Voraussetzung dafür, dass diese Antwort „Ja“ lautet.
Für die Werksleitung und das Operations-Management geht es um Verlässlichkeit. Ein Planungssystem, dem die Schichtleiter nicht trauen, wird übersteuert. Ein Instandhaltungsalarm, der dreimal falsch lag, wird ignoriert. Saubere Material- und Anlagendaten sind deshalb kein Selbstzweck, sondern die Grundlage für Akzeptanz im Werk.
Für die IT-Leitung geht es um Architektur und Aufwand. Jede Punkt-zu-Punkt-Schnittstelle zwischen ERP, MES, PLM und IoT-Plattform, die Daten umschlüsselt, ist eine potenzielle Fehlerquelle. Eine zentrale Golden Source reduziert diese Mappings und schafft Zeit für neue Use Cases statt für Datenreparaturen.
Für Instandhaltung, Qualität und Arbeitsvorbereitung geht es um den Alltag. Ein System, das die richtige Anlage, die richtige Variante und den richtigen Stand kennt, nimmt Arbeit ab. Ein System, das ständig korrigiert werden muss, erzeugt neue. Wer hier als Data Steward mitwirkt, gestaltet die Werkzeuge mit, mit denen er künftig arbeitet.
Best Practices: Was bei KI in der Fertigung wirklich funktioniert
Aus erfolgreichen Projekten lassen sich einige Muster ableiten, die unabhängig von Branche und Unternehmensgröße gelten.
Mit dem Stillstand anfangen, nicht mit der Technologie.
Projekte, die mit einer konkreten Kennzahl starten – Stillstandsstunden, Ausschussquote, Liefertreue – gewinnen schneller Rückhalt im Werk. Die Technologieauswahl folgt dem Problem, nicht umgekehrt.
Stammdaten als Teil des KI-Projekts budgetieren.
Datenbereinigung ist keine Vorarbeit, die „nebenbei“ passiert. Planen Sie sie als eigenes Arbeitspaket mit Verantwortung, Zeit und Budget ein. Wer das nicht tut, verlagert die Kosten in eine spätere Projektphase, in der sie teurer werden.
Das Werk zum Mitgestalter machen.
Instandhalter und Schichtleiter wissen, welche Anlage im System falsch zugeordnet ist. Binden Sie sie früh ein, etwa als Data Stewards für ihre Linie. Das erhöht die Datenqualität und die Akzeptanz der KI-Ergebnisse.
Eine Referenz für alle Systeme schaffen.
Lassen Sie nicht jedes System seine eigene Wahrheit führen. Eine zentrale Golden Source für Material, Anlage und Lieferant verteilt verbindliche Daten an ERP, MES, PLM und IoT-Plattform. So entsteht der „gemeinsame Wortschatz“, den eine Smart Factory braucht.
Standards nutzen, wo sie existieren.
Klassifizierungsstandards wie ECLASS und das Konzept der Verwaltungsschale (Asset Administration Shell) der Plattform Industrie 4.0 erleichtern den Datenaustausch mit Lieferanten und Maschinenherstellern. Ein Golden Record ist der natürliche Ort, um diese Standards intern verbindlich zu machen.
Regulatorik von Anfang an mitdenken.
Seit 12. September 2025 gilt der EU Data Act. Er regelt den Zugang zu Daten vernetzter Produkte, ausdrücklich auch von Industriemaschinen.
Für KI in regulierten Produkten wie Maschinen greifen die Hochrisiko-Pflichten des EU AI Act nach der Digital-Omnibus-Einigung ab 2. August 2028.
Artikel 10 verlangt dann nachweisbare Daten-Governance für Trainings-, Validierungs- und Testdaten. Wer seine Stammdaten heute dokumentiert und versioniert, hat diesen Nachweis später in der Hand. Einen Überblick über die Fristen gibt unser Leitfaden zum EU AI Act 2026.
Drei Wege zur Datenbasis für KI in der Fertigung im Vergleich
Unternehmen wählen in der Praxis meist einen von drei Wegen, um ihre KI-Use-Cases mit Daten zu versorgen. Die folgende Übersicht zeigt die Unterschiede.
Kriterium | Projektlokale Datenaufbereitung | Zentrale IoT- oder Datenplattform ohne MDM | MDM-gestützte Golden Source |
Grundidee | Jedes KI-Projekt bereinigt seine Daten selbst | Alle Rohdaten an einem Ort sammeln | Verbindliche Stammdaten für alle Systeme bereitstellen |
Zeit bis zum ersten Ergebnis | Kurz | Mittel | Mittel |
Übertragbarkeit auf weitere Werke | Gering – Bereinigung beginnt von vorn | Mittel – Daten liegen zentral, Bedeutung bleibt uneinheitlich | Hoch – Objekte sind werksübergreifend eindeutig |
Konsistenz zwischen ERP, MES, PLM | Nicht adressiert | Teilweise, abhängig von Mapping-Regeln | Systematisch über Golden Records |
Aufwand pro weiterem Use Case | Bleibt hoch | Sinkt bei Bewegungsdaten, nicht bei Stammdaten | Sinkt deutlich |
Governance und Verantwortlichkeit | Liegt beim Projektteam | Liegt meist bei der IT | Fachliche Data Owner mit Workflows |
Nachweisfähigkeit (AI Act, Data Act) | Schwach | Mittel | Stark – Herkunft und Änderungen dokumentiert |
Typischer Einsatz | Proof of Concept | Datensammlung und Monitoring | Skalierung über Werke und Use Cases |
Die Wege schließen sich nicht aus. Eine IoT-Plattform ist für Sensordaten unverzichtbar. Ein Proof of Concept darf pragmatisch sein.
Entscheidend ist, dass die Stammdaten-Ebene nicht in jedem Projekt neu erfunden wird. Wer skalieren will, braucht die dritte Spalte als Fundament unter den beiden anderen.
Praxis-Szenario: Wie ein Maschinenbauer seinen Predictive-Maintenance-Pilot skaliert
Das folgende Szenario ist anonymisiert und aus typischen Projektverläufen in der Fertigungsindustrie verdichtet. Es enthält bewusst keine Kennzahlen eines einzelnen Kunden.
Die Ausgangslage.
Ein mittelständischer Maschinenbauer aus der DACH-Region betreibt drei Werke, zwei davon aus Übernahmen. Ein Pilot zur KI in der Instandhaltung läuft an einer Fräslinie im Stammwerk erfolgreich. Das Modell erkennt Lagerschäden an Spindeln mehrere Tage im Voraus. Die Geschäftsführung möchte das Modell auf alle Werke ausrollen.
Das Problem.
Im zweiten Werk liefert das Modell kaum brauchbare Ergebnisse.
Die Analyse zeigt: Dieselben Maschinentypen sind dort unter anderen Bezeichnungen angelegt. Die Equipment-Hierarchie ist anders aufgebaut, Ersatzteile sind mit werksspezifischen Materialnummern hinterlegt. Ein Teil der Sensoren ist keiner Anlage im Instandhaltungssystem eindeutig zugeordnet. Das Modell lernt also nicht „Spindel Baureihe X“, sondern „Sensor mit unklarer Herkunft“.
Der Ansatz.
Statt das Modell für jedes Werk neu zu trainieren, setzt das Unternehmen bei den Stammdaten an. Es erstellt eine Datenlandkarte für den Use Case und definiert vier Kernobjekte: Anlage, Baureihe, Ersatzteil, Standort. Für diese Objekte entstehen werksübergreifende Golden Records mit einheitlicher Klassifizierung. Jedes Werk erhält einen Data Steward aus der Instandhaltung, der neue Anlagen und Änderungen freigibt.
Das Ergebnis.
Die Golden Records werden an IoT-Plattform, Instandhaltungssystem und ERP verteilt. Jede Zeitreihe trägt nun eine eindeutige Anlagen- und Baureihen-Referenz. Das Modell lässt sich auf vergleichbare Maschinen in den anderen Werken übertragen, ohne die Datenbasis jeweils neu aufzubereiten. Der zweite Use Case – eine KI-gestützte Ersatzteilplanung – nutzt dieselben Golden Records und startet mit deutlich geringerem Vorlauf.
Die Lektion.
Der Durchbruch kam nicht durch ein besseres Modell. Er kam durch die Entscheidung, die Identität der Objekte einmal verbindlich zu klären. Genau das meinen wir, wenn wir von Klarheit im Datenchaos sprechen.
Wie Fertigungsunternehmen diesen Weg mit Goldright gehen, zeigt unsere Seite MDM für die Fertigung.
Fallstricke: Was Sie bei KI in der Fertigung vermeiden sollten
Den Pilot mit dem Produkt verwechseln.
Ein Pilot beweist, dass ein Modell unter kontrollierten Bedingungen funktioniert. Er beweist nicht, dass die Datenbasis skaliert. Planen Sie die Übertragung auf ein zweites Werk von Beginn an mit – als Test für die Datenqualität.
Daten im Projekt bereinigen und danach verfallen lassen.
Viele Teams bereinigen Stammdaten einmalig für das Training. Sechs Monate später sind neue Dubletten entstanden, und das Modell verliert an Genauigkeit. Ohne laufende Governance ist jede Bereinigung ein Verfallsdatum.
Alles auf einmal lösen wollen.
Das Gegenteil ist ebenso riskant: ein Mammutprojekt, das alle Stammdaten aller Werke harmonisieren soll, bevor die erste KI startet. Solche Vorhaben verlieren Rückhalt, bevor sie Nutzen zeigen. Arbeiten Sie Use Case für Use Case.
Die IT allein lassen.
Stammdaten in der Fertigung sind Fachwissen. Wenn die IT Anlagen-Hierarchien ohne Instandhaltung definiert oder Materialklassen ohne Konstruktion, entstehen Strukturen, die im Werk niemand pflegt.
Generative KI auf ungeprüfte Dokumente setzen.
KI-Assistenten für Instandhaltung oder Arbeitsvorbereitung sind attraktiv. Greifen sie auf Handbücher und Wartungsberichte zu, die keiner Anlage eindeutig zugeordnet sind, liefern sie überzeugend formulierte Antworten zur falschen Maschine. Mehr dazu, warum über 80 % der KI-Projekte an schlechter Datenqualität scheitern, lesen Sie in unserem Grundlagenbeitrag.
Regulatorik als späteres Problem behandeln.
Die Pflichten aus Data Act und AI Act kommen schrittweise. Wer Herkunft und Änderungen seiner Daten erst dokumentiert, wenn eine Prüfung ansteht, rekonstruiert unter Zeitdruck. Ein versionierter Golden Record macht diesen Nachweis zum Nebenprodukt des Regelbetriebs.
Bevor Sie den nächsten KI-Pilot starten
Prüfen Sie zuerst das Fundament. Der AI Data Foundation Check hilft Ihnen, die Datenbasis Ihres geplanten Use Cases strukturiert zu bewerten – von Materialdubletten über Stücklisten-Brüche bis zur Anlagenzuordnung. So wissen Sie vor dem Projektstart, ob Ihr Modell im zweiten Werk genauso funktioniert wie im ersten.
Fazit: Künstliche Intelligenz in der Fertigung beginnt bei den Stammdaten
Künstliche Intelligenz in der Fertigung ist kein Zukunftsthema mehr. 40 % der deutschen Industrieunternehmen setzen sie in der Produktion ein. Doch nur ein Bruchteil der Initiativen erreicht den erwarteten Return on Investment, und noch weniger werden unternehmensweit skaliert. Die Lücke zwischen Pilot und Regelbetrieb ist selten eine Frage des Modells.
Sie ist eine Frage der Identität. Eine KI kann nur dann vorhersagen, wann eine Maschine ausfällt, wenn sie weiß, welche Maschine sie gerade betrachtet. Sie kann nur dann einen Plan optimieren, wenn die Stückliste stimmt. Und sie kann nur dann Fehler erkennen, wenn klar ist, welche Variante auf dem Prüfstand liegt.
Für die Geschäftsführung bedeutet das: Investitionen in KI in der Instandhaltung, Produktionsplanung und Qualitätssicherung zahlen sich erst dann vollständig aus, wenn die Stammdaten für Material, Anlage und Lieferant verbindlich geklärt sind. Für die IT heißt es: weniger Zeit für das Zusammenflicken von Datenfeldern, mehr Zeit für neue Use Cases. Für die Teams im Werk heißt es: Systeme, deren Empfehlungen man vertrauen kann.
Der Weg dorthin ist kein Großprojekt. Er beginnt mit einem Use Case, einer Datenlandkarte und dem Entschluss, die kritischen Objekte einmal sauber zu führen. Daraus entsteht Schritt für Schritt die Golden Source, auf der Ihre Smart Factory skaliert.
Machen Sie den ersten Schritt: Mit dem AI Data Foundation Check sehen Sie, wo Ihre Datenbasis heute steht und welcher Use Case als erster skalieren kann. Oder sprechen Sie direkt mit uns – wir zeigen Ihnen, wie Goldright Klarheit in Ihre Fertigungsdaten bringt.
Häufige Fragen
- KI in der Fertigung wird vor allem in vier Bereichen eingesetzt: in der Instandhaltung (Predictive Maintenance), in der Produktionsplanung (Reihenfolge, Kapazität, Materialbedarf), in der Qualitätssicherung (Bildverarbeitung, Ursachenanalyse) sowie in der Fertigungs- und Energieoptimierung. Hinzu kommen generative KI-Assistenten, etwa für Instandhaltungswissen oder Arbeitsanweisungen. Laut Bitkom nutzen 40 % der deutschen Industrieunternehmen KI bereits in der Produktion.
- KI in der Fertigung braucht Bewegungsdaten und Stammdaten. Bewegungsdaten sind Sensorwerte, Aufträge, Prüfergebnisse und Zeitstempel. Stammdaten beschreiben die Objekte, auf die sich diese Werte beziehen: Material, Stückliste, Arbeitsplan, Anlage, Lieferant und Standort. Erst die eindeutige Verknüpfung beider Datenarten macht ein Modell zuverlässig und auf andere Linien oder Werke übertragbar.
- Die häufigste Ursache ist nicht der Algorithmus, sondern die Datenbasis. Gartner erwartet, dass 60 % der KI-Projekte ohne KI-fähige Daten bis Ende 2026 abgebrochen werden. In der Fertigung sind typische Gründe Materialdubletten über mehrere Werke, Sensordaten ohne eindeutigen Anlagenbezug, abweichende Stücklisten zwischen PLM, ERP und MES sowie fehlende Verantwortlichkeiten für Stammdaten.
- Die Smart Factory ist ein vernetztes Werk, in dem Maschinen, Systeme und Menschen Informationen in Echtzeit austauschen. KI in der Fertigung ist die Analyse- und Entscheidungsschicht innerhalb dieser Smart Factory: Sie wertet die vernetzten Daten aus und erzeugt Vorhersagen, Empfehlungen oder automatische Aktionen. Ohne Vernetzung fehlen der KI die Daten, ohne KI fehlt der Smart Factory die Intelligenz.
- KI in der Instandhaltung erkennt Muster in Maschinendaten, die einem Ausfall vorausgehen. Damit lassen sich Wartungen planen, ungeplante Stillstände reduzieren und Ersatzteile gezielter bevorraten. Voraussetzung ist, dass jeder Sensor einer Anlage eindeutig zugeordnet ist und die Equipment-Hierarchie in allen Systemen übereinstimmt. Sonst entstehen Fehlalarme, die das Vertrauen der Instandhaltung untergraben.
- Master Data Management (MDM) schafft die verbindliche Referenz für alle Objekte, mit denen eine KI arbeitet. Es konsolidiert Material-, Anlagen- und Lieferantendaten zu Golden Records, regelt Verantwortlichkeiten und verteilt geprüfte Daten an ERP, MES, PLM und IoT-Plattformen. Dadurch muss nicht jedes KI-Projekt seine Daten neu bereinigen, und Modelle lassen sich über Werke hinweg skalieren.
- Perfekte Stammdaten sind keine Voraussetzung. Starten Sie mit einem Use Case, der einen klaren Business Case hat, und erstellen Sie eine Datenlandkarte nur für die Objekte, die dieser Use Case braucht. Bereinigen und konsolidieren Sie diese Objekte, verankern Sie Verantwortlichkeiten und messen Sie die Datenqualität laufend. So wächst die Datenbasis mit jedem weiteren Anwendungsfall.
- Zwei EU-Verordnungen sind besonders relevant. Der EU Data Act gilt seit 12. September 2025 und regelt den Zugang zu Daten vernetzter Produkte, auch von Industriemaschinen. Der EU AI Act stellt Anforderungen an KI-Systeme; für KI als Teil regulierter Produkte wie Maschinen greifen die Hochrisiko-Pflichten nach der Digital-Omnibus-Einigung ab 2. August 2028. Artikel 10 fordert dann nachweisbare Daten-Governance.
Quellenverzeichnis
Bitkom e. V.: Humanoide Roboter, KI & Co.: Die digitale Transformation der Industrie geht in die nächste Runde - bitkom.org
Bitkom e. V.: Industrie 4.0: 42 Prozent der Unternehmen setzen KI in der Produktion ein. - bitkom.org
Bitkom e. V.: Drei Viertel der Industrie lassen KI-Chancen liegen - bitkom.org
Statistisches Bundesamt (Destatis): Unternehmen mit Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen - destatis.de
Statistisches Bundesamt (Destatis): Gründe gegen die Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen - destatis.de
Gartner: Lack of AI-Ready Data Puts AI Projects at Risk - gartner.com
Gartner: Data Quality: Why It Matters and How to Achieve It - gartner.com
IBM Institute for Business Value: IBM Study: CEOs Double Down on AI While Navigating Enterprise Hurdles - newsroom.ibm.com
McKinsey & Company: The State of AI - mckinsey.com
Deloitte: 2025 Smart Manufacturing and Operations Survey - deloitte.com
World Economic Forum: Global Lighthouse Network Recognizes 23 New Sites, Launches AI Platform for Industrial Transformation - weforum.org
Europäische Kommission: Data Act (anwendbar seit 12.09.2025) - digital-strategy.ec.europa.eu
EU AI Act, Artikel 10: Daten und Daten-Governance - artificialintelligenceact.eu
r.at: Digital Omnibus final: Was am 2.8.2026 im EU AI Act wirklich gilt - r.at
Plattform Industrie 4.0: Verwaltungsschale und Standardisierung - plattform-i40.de
Bringen Sie jetzt Klarheit in Ihr Daten-Chaos
Finden Sie heraus, wie Goldright Ihrem Unternehmen dabei helfen kann, Herausforderungen im Datenmanagement zu meistern.